












 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
Nachrichtenartikel zu Kryptowährungen
Winziges Modell, rekursiv, maschinelles Lernen: Weniger ist mehr?
Oct 20, 2025 at 02:31 am
Erkundung des Trends zu winzigen, rekursiven Modellen beim maschinellen Lernen mit Schwerpunkt auf TRM und seinen Auswirkungen auf Effizienz und Leistung.
The world of machine learning is constantly evolving, with researchers always seeking ways to improve performance and efficiency. Lately, there's been buzz around 'Tiny model, recursive, machine learning' approaches. Let's dive into what's shaking in this field.
Die Welt des maschinellen Lernens entwickelt sich ständig weiter und Forscher suchen stets nach Möglichkeiten, Leistung und Effizienz zu verbessern. In letzter Zeit wird viel über Ansätze des „winzigen Modells, des rekursiven maschinellen Lernens“ gesprochen. Werfen wir einen Blick auf die Ereignisse in diesem Bereich.
The Rise of Tiny Recursive Models
Der Aufstieg winziger rekursiver Modelle
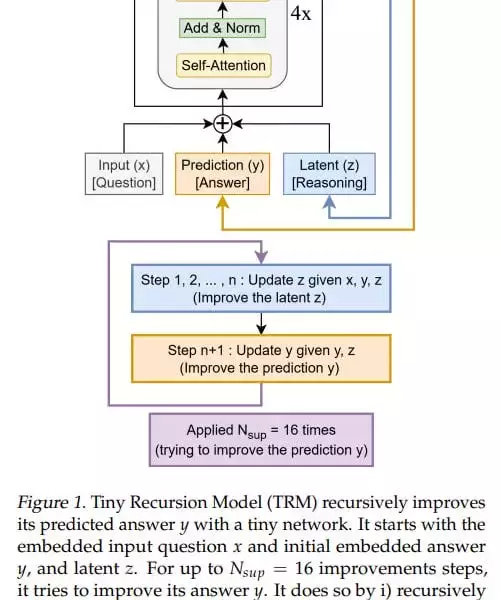
The recent work on TRM (Tiny Recursive Model) is questioning the necessity of complexity. TRM contains 5M-19M parameters, versus 27M in HRM. These models represent a fascinating shift towards simplicity and efficiency, challenging the conventional wisdom that bigger is always better.
Die jüngsten Arbeiten zu TRM (Tiny Recursive Model) stellen die Notwendigkeit von Komplexität in Frage. TRM enthält 5 bis 19 Millionen Parameter, im Vergleich zu 27 Millionen im HRM. Diese Modelle stellen einen faszinierenden Wandel hin zu Einfachheit und Effizienz dar und stellen die gängige Meinung in Frage, dass größer immer besser ist.
TRM: A Closer Look
TRM: Ein genauerer Blick
TRM simplifies the recursive process, designed with one small network, which is essentially a standard transformer block: [self-attention, norm, MLP, norm]. The model is designed so that there’s one small network, which is essentially a standard transformer block: [self-attention, norm, MLP, norm]. In the original idea, there were 4 such blocks (but after experiments they came to 2).
TRM vereinfacht den rekursiven Prozess, der mit einem kleinen Netzwerk entworfen wurde, das im Wesentlichen ein Standardtransformatorblock ist: [Selbstaufmerksamkeit, Norm, MLP, Norm]. Das Modell ist so konzipiert, dass es ein kleines Netzwerk gibt, das im Wesentlichen ein Standardtransformatorblock ist: [Selbstaufmerksamkeit, Norm, MLP, Norm]. In der ursprünglichen Idee gab es 4 solcher Blöcke (nach Experimenten kamen sie jedoch auf 2).
At the input, it has three elements: input (x), latent (z), and prediction (y); they’re all summed into one value. The basic iteration, analogous to the L module in HRM, generates a latent value (z, also denoted in the recursion formula as z_L) at the layer output, and the updated z goes back to the module input, where it now adds to input (x) not as zero. The output-prediction (y, also denoted in the formula as z_H) is also added, but since it hasn’t been updated, it doesn’t change anything.
Am Eingang gibt es drei Elemente: Eingabe (x), latent (z) und Vorhersage (y); Sie werden alle zu einem Wert zusammengefasst. Die grundlegende Iteration, analog zum L-Modul in HRM, generiert einen latenten Wert (z, in der Rekursionsformel auch als z_L bezeichnet) am Layer-Ausgang, und der aktualisierte z geht zurück zum Moduleingang, wo er nun zum Eingang (x) hinzugefügt wird, nicht als Null. Die Ausgabevorhersage (y, in der Formel auch als z_H bezeichnet) wird ebenfalls hinzugefügt, aber da sie nicht aktualisiert wurde, ändert sie nichts.
Key Insights and Performance
Wichtige Erkenntnisse und Leistung
TRM achieves higher numbers than HRM: 74.7%/87.4% (attention version/MLP version) versus 55% for Sudoku, 85.3% (attention version, MLP version gives 0) versus 74.5% for Maze, 44.6%/29.6% (attn/MLP) versus 40.3% for ARC-AGI-1 and 7.8%/2.4% (attn/MLP) versus 5.0% for ARC-AGI-2. The experiments don’t look very expensive; runtime from <24 hours to about three days maximum on 4*H100 according to the repo.
TRM erreicht höhere Zahlen als HRM: 74,7 %/87,4 % (Aufmerksamkeitsversion/MLP-Version) gegenüber 55 % für Sudoku, 85,3 % (Aufmerksamkeitsversion, MLP-Version gibt 0) gegenüber 74,5 % für Labyrinth, 44,6 %/29,6 % (Aufmerksamkeitsversion/MLP) gegenüber 40,3 % für ARC-AGI-1 und 7,8 %/2,4 % (attn/MLP) gegenüber 5,0 % für ARC-AGI-2. Die Experimente sehen nicht sehr teuer aus; Laufzeit von <24 Stunden bis maximal etwa drei Tage auf 4*H100 laut Repo.
My Two Cents
Meine zwei Cent
While the theoretical underpinnings of why these recursions work so well might not be fully understood yet, the empirical results are hard to ignore. TRM's architectural inventiveness, as opposed to eternal model scaling, is a breath of fresh air. It would be interesting how it would be with dataset scaling.
Während die theoretischen Grundlagen, warum diese Rekursionen so gut funktionieren, möglicherweise noch nicht vollständig verstanden sind, sind die empirischen Ergebnisse schwer zu ignorieren. Der architektonische Erfindungsreichtum von TRM ist im Gegensatz zur ewigen Modellskalierung ein Hauch frischer Luft. Es wäre interessant, wie es mit der Datensatzskalierung wäre.
Looking Ahead
Blick nach vorn
The journey of 'Tiny model, recursive, machine learning' is just beginning. There's a lot more to explore. So, let's keep an eye on these tiny titans and see where they take us next. Good recursions to everyone!
Die Reise des „winzigen Modells, rekursives, maschinelles Lernen“ hat gerade erst begonnen. Es gibt noch viel mehr zu entdecken. Behalten wir also diese winzigen Titanen im Auge und schauen wir, wohin sie uns als nächstes führen. Gute Rekursionen an alle!
Haftungsausschluss:info@kdj.com
Die bereitgestellten Informationen stellen keine Handelsberatung dar. kdj.com übernimmt keine Verantwortung für Investitionen, die auf der Grundlage der in diesem Artikel bereitgestellten Informationen getätigt werden. Kryptowährungen sind sehr volatil und es wird dringend empfohlen, nach gründlicher Recherche mit Vorsicht zu investieren!
Wenn Sie glauben, dass der auf dieser Website verwendete Inhalt Ihr Urheberrecht verletzt, kontaktieren Sie uns bitte umgehend (info@kdj.com) und wir werden ihn umgehend löschen.
-

- Trezor sieht sich dieses Jahr mit Datenschutzverletzungen durch Dritte konfrontiert: Die Bedenken hinsichtlich Kundendaten, Partnerverletzungen und Datenschutzverletzungen durch Dritte nehmen zu
- Nov 17, 2026 at 12:05 pm
- Trezor-Kundendaten, Verstöße von Partnern und Vorfälle von Verstößen Dritter verdeutlichen erhebliche Risiken für Krypto-Inhaber. Durch einen kürzlichen Verstoß beim Versandpartner Skladon wurden nach früheren Vorfällen 27.000 Bestellungen aufgedeckt.
-
- Injektive (INJ)-Preisanalyse: ETF-Boost und Protokoll-Upgrades fördern die Dynamik von Krypto-Assets
- Nov 17, 2026 at 11:55 am
- Der INJ-Preis von Injective verzeichnet einen Anstieg, der durch den ersten in den USA notierten Stake-ETF und das bevorstehende Veyra-Upgrade angeheizt wird, was auf eine starke Dynamik der Krypto-Assets hinweist.
-
- Pepe (PEPE)-Preisanstieg: Ein Hoffnungsschimmer in einem Meer der Angst?
- Nov 17, 2026 at 11:55 am
- Nach einer schwierigen Woche zeigt Pepe (PEPE) mit einem leichten Preisanstieg ein Lebenszeichen, sodass sich die Anleger fragen, ob es sich hierbei um eine echte Erholung oder nur um einen Boxenstopp vor einem weiteren Rückgang handelt.
-
-
-
- Solana unterstützt die Tokenisierungspläne der Wall Street: Eine Vision für 2027
- Nov 16, 2026 at 08:05 am
- DTCC integriert Solana bis 2027 in seinen Tokenisierungsdienst und ermöglicht so die Tokenisierung von Wertpapieren im Wert von 114 Billionen US-Dollar, was die Rolle der Blockchain bei der Verbindung traditioneller Finanzen mit digitalen Vermögenswerten unterstreicht.
-
- Kava Lend Hack: Millionen an KAVA-Token verloren, Ökosystemsicherheit auf dem Prüfstand
- Nov 16, 2026 at 08:00 am
- Kava Lend ist mit einem erheblichen KAVA-Token-Verlust aufgrund eines Hacks konfrontiert, der eine Marktlücke ausnutzt, was kritische Fragen zur Sicherheit des Kava-Ökosystems und zur Wiederherstellung von Benutzergeldern aufwirft.
-
- DTCC begrüßt die Multichain-Zukunft: Was das für Solana und das XRP-Ledger bedeutet
- Nov 16, 2026 at 04:05 am
- DTCC weitet seine Tokenisierungsstrategie auf mehrere Blockchain-Netzwerke aus, wobei Solana eine wichtige Integration sichert. Dieser Multichain-Ansatz verändert die Landschaft für digitale Vermögenswerte und wirft Fragen über die Rolle des XRP-Ledgers in dieser sich entwickelnden Finanzinfrastruktur auf.
-
- Sui Network, Toncoin, TRON: Navigieren in der sich entwickelnden Kryptolandschaft
- Nov 14, 2026 at 11:55 pm
- Inmitten von Marktveränderungen zeigen Sui Network, Toncoin und TRON unterschiedliche Wachstumspfade und Herausforderungen auf. Dieser Bericht analysiert ihre neuesten Bewegungen, von der Kontoausweitung von TRON über die Ökosystemanpassungen von Sui bis hin zur Telegram-Integration von Toncoin, und bietet Einblicke für den anspruchsvollen Anleger.


