









 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
Articles d’actualité sur les crypto-monnaies
Patchscopes: chirurgie sur les neurones des modèles de grande langue (LLMS)
Feb 23, 2025 at 01:00 am
Les grands modèles de langue (LLM) ont révolutionné le domaine de l'intelligence artificielle, démontrant des capacités remarquables dans la compréhension et la génération du langage naturel. Ces modèles, composés de couches de neurones artificiels interconnectés, communiquent à travers des vecteurs de nombres appelés représentations cachées. Cependant, le déchiffrer le sens codé au sein de ces représentations cachées a été un défi important. Le domaine de l'interprétabilité de l'apprentissage automatique cherche à combler cet écart et "PatchScopes" que les chercheurs de Google ont trouvé une méthode pour comprendre ce que LLM "pense".
Large Language Models (LLMs) have revolutionized the field of artificial intelligence, demonstrating remarkable capabilities in natural language understanding and generation. These models, comprised of layers of interconnected artificial neurons, communicate through vectors of numbers known as hidden representations. However, deciphering the meaning encoded within these hidden representations has been a significant challenge. The field of machine learning interpretability seeks to bridge this gap, and "Patchscopes" that Google researchers came up with a method to understand what LLM “thinks”.
Les grands modèles de langue (LLM) ont révolutionné le domaine de l'intelligence artificielle, démontrant des capacités remarquables dans la compréhension et la génération du langage naturel. Ces modèles, composés de couches de neurones artificiels interconnectés, communiquent à travers des vecteurs de nombres appelés représentations cachées. Cependant, le déchiffrer le sens codé au sein de ces représentations cachées a été un défi important. Le domaine de l'interprétabilité de l'apprentissage automatique cherche à combler cet écart et "PatchScopes" que les chercheurs de Google ont trouvé une méthode pour comprendre ce que LLM "pense".
Patchscopes is a novel interpretability method that enables researchers to perform "surgery" on the neurons of an LLM. This involves cutting out and replacing hidden representations between different prompts and layers, allowing for a detailed inspection of the information contained within. The core concept is the "inspection prompt," which acts as a lens into the LLM's mind, facilitating the extraction of human-interpretable meaning. The framework leverages the inherent ability of LLMs to translate their own hidden representations into understandable text.
PatchScopes est une nouvelle méthode d'interprétabilité qui permet aux chercheurs d'effectuer une "chirurgie" sur les neurones d'un LLM. Cela implique de couper et de remplacer les représentations cachées entre différentes invites et couches, permettant une inspection détaillée des informations contenues à l'intérieur. Le concept principal est «l'invite d'inspection», qui agit comme un objectif dans l'esprit du LLM, facilitant l'extraction de la signification interprétable humaine. Le cadre exploite la capacité inhérente des LLM à traduire leurs propres représentations cachées en texte compréhensible.
Understanding the Transformer Architecture: A Foundation for Patchscopes
Comprendre l'architecture du transformateur: une base pour les patchscopes
Patchscopes builds upon a deep understanding of LLMs and the transformer architecture, which forms the backbone of many modern language models. Transformer models process text by first tokenizing the input, breaking it down into smaller units (words or sub-words). Each token is then embedded into a high-dimensional vector space, creating an initial hidden representation.
PatchScopes s'appuie sur une compréhension approfondie des LLM et de l'architecture du transformateur, qui forme l'épine dorsale de nombreux modèles de langage modernes. Les modèles de transformateur traitent le texte par premier tokenisation de l'entrée, le décomposant en unités plus petites (mots ou sous-mots). Chaque jeton est ensuite intégré à un espace vectoriel à haute dimension, créant une représentation cachée initiale.
The transformer architecture consists of multiple layers of transformer blocks. Each layer refines the hidden representation based on the output of the preceding layer and the relationships between tokens in the input sequence. This process continues through the final layer, where the hidden representation is used to generate the output text. Decoder-only models, which are the focus of Patchscopes, only consider preceding tokens when generating the next token, making them particularly well-suited for language generation tasks.
L'architecture du transformateur se compose de plusieurs couches de blocs de transformateurs. Chaque couche affine la représentation cachée en fonction de la sortie de la couche précédente et des relations entre les jetons dans la séquence d'entrée. Ce processus se poursuit à travers la couche finale, où la représentation cachée est utilisée pour générer le texte de sortie. Les modèles uniquement du décodeur, qui sont au centre des pots-opcopes, ne considèrent que les jetons précédents lors de la génération du token suivant, ce qui les rend particulièrement bien adaptés aux tâches de génération de langue.
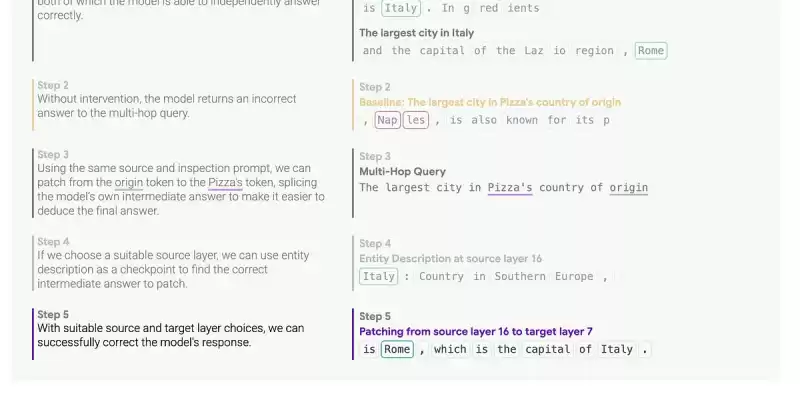
The Patchscopes framework operates on a simple yet powerful premise: LLMs possess the inherent ability to translate their own hidden representations into human-understandable text. By patching hidden representations between different locations during inference, researchers can inspect the information within a hidden representation, understand LLM behavior, and even augment the model's performance.
Le framework PatchScopes fonctionne sur une prémisse simple mais puissante: les LLMS possèdent la capacité inhérente à traduire leurs propres représentations cachées dans un texte indispensable humain. En corrigeant les représentations cachées entre différents emplacements pendant l'inférence, les chercheurs peuvent inspecter les informations dans une représentation cachée, comprendre le comportement de LLM et même augmenter les performances du modèle.
The process involves several key steps:
Le processus implique plusieurs étapes clés:
Source Prompt: A source prompt is fed into the LLM, generating hidden representations at each layer. This prompt serves as the context from which information will be extracted.
Invite source: une invite source est introduite dans le LLM, générant des représentations cachées à chaque couche. Cette invite sert de contexte à partir duquel les informations seront extraites.
Inspection Prompt: An inspection prompt is designed to elicit a specific type of information from the LLM. This prompt typically includes a placeholder token where the hidden representation from the source prompt will be inserted.
Invite d'inspection: Une invite d'inspection est conçue pour provoquer un type spécifique d'informations du LLM. Cette invite comprend généralement un jeton d'espace réservé où la représentation cachée de l'invite source sera insérée.
Patching: The hidden representation from a specific layer and token position in the source prompt is "patched" into the placeholder token in the inspection prompt. This effectively replaces the LLM's internal representation with the extracted information.
Patchage: La représentation cachée d'une couche spécifique et de la position de jeton dans l'invite de source est "correcte" dans le jeton d'espace réservé dans l'invite d'inspection. Cela remplace efficacement la représentation interne de la LLM par les informations extraites.
Generation: The LLM continues decoding from the patched inspection prompt, generating text based on the combined information from the source and inspection prompts.
GÉNÉRATION: Le LLM continue le décodage à partir de l'invite d'inspection corrigée, générant du texte basé sur les informations combinées à partir de la source et des invites d'inspection.
Analysis: The generated text is analyzed to understand the information encoded in the hidden representation. This can involve evaluating the accuracy of factual information, identifying the concepts captured by the representation, or assessing the model's reasoning process.
Analyse: Le texte généré est analysé pour comprendre les informations codées dans la représentation cachée. Cela peut impliquer l'évaluation de la précision des informations factuelles, l'identification des concepts capturés par la représentation ou l'évaluation du processus de raisonnement du modèle.
Case Study 1: Entity Resolution
Étude de cas 1: Résolution des entités
The first case study explores how LLMs resolve entities (people, places, movies, etc.) across different layers of the model. The goal is to understand at what point the model associates a token with its correct meaning. For example, how does the model determine that "Diana" refers to "Princess Diana" rather than the generic name?
La première étude de cas explore comment les LLMS résolvent les entités (personnes, lieux, films, etc.) sur différentes couches du modèle. L'objectif est de comprendre à quel moment le modèle associe un jeton à sa signification correcte. Par exemple, comment le modèle détermine-t-il que "Diana" fait référence à la "princesse Diana" plutôt qu'au nom générique?
To investigate this, a source prompt containing the entity name is fed into the LLM. The hidden representation of the entity token is extracted at each layer and patched into an inspection prompt designed to elicit a description of the entity. By analyzing the generated descriptions, researchers can determine when the model has successfully resolved the entity.
Pour enquêter, une invite source contenant le nom de l'entité est introduite dans le LLM. La représentation cachée du jeton d'entité est extraite à chaque couche et corrigé dans une invite d'inspection conçue pour provoquer une description de l'entité. En analysant les descriptions générées, les chercheurs peuvent déterminer quand le modèle a résolu avec succès l'entité.
The results of this case study suggest that entity resolution typically occurs in the early layers of the model (before layer 20). This aligns with theories about layer function, which posit that early layers are responsible for establishing context from the prompt. The study also reveals that tokenization (how the input text is broken down into tokens) has a significant impact on how the model navigates its embedding space.
Les résultats de cette étude de cas suggèrent que la résolution des entités se produit généralement dans les premières couches du modèle (avant la couche 20). Cela s'aligne sur les théories sur la fonction de couche, qui postulent que les premières couches sont responsables de l'établissement du contexte à partir de l'invite. L'étude révèle également que la tokenisation (comment le texte d'entrée est décomposé en jetons) a un impact significatif sur la façon dont le modèle navigue dans son espace d'incorporation.
Case Study 2: Attribute Extraction
Étude de cas 2: Extraction d'attribut
The second case study focuses on evaluating how accurately the model's hidden representation captures well-known concepts and their attributes. For example, can the model identify that the largest city in Spain is Madrid?
La deuxième étude de cas se concentre sur l'évaluation de la précision de la représentation cachée du modèle capture des concepts bien connus et de leurs attributs. Par exemple, le modèle peut-il identifier que la plus grande ville d'Espagne est Madrid?
To extract an attribute, a source prompt containing the subject (e.g., "Spain") is fed into the LLM. The hidden representation of the subject token is extracted and patched into an inspection prompt designed to elicit the specific attribute (e.g., "The largest city is x"). By analyzing the generated text, researchers can determine whether the model correctly identifies the attribute.
Pour extraire un attribut, une invite source contenant le sujet (par exemple, "Espagne") est introduite dans le LLM. La représentation cachée du jeton de sujet est extraite et corrigée dans une invite d'inspection conçue pour provoquer l'attribut spécifique (par exemple, "La plus grande ville est X"). En analysant le texte généré, les chercheurs peuvent déterminer si le modèle identifie correctement l'attribut.
This case study compares Patchscopes to a technique called "probing," which involves training a classifier to predict an attribute from a hidden representation. Unlike probing, Patchscopes does not
Cette étude de cas compare les patchscopes à une technique appelée «sondage», ce qui implique de former un classificateur pour prédire un attribut d'une représentation cachée. Contrairement au sondage, PatchScopes ne
Clause de non-responsabilité:info@kdj.com
Les informations fournies ne constituent pas des conseils commerciaux. kdj.com n’assume aucune responsabilité pour les investissements effectués sur la base des informations fournies dans cet article. Les crypto-monnaies sont très volatiles et il est fortement recommandé d’investir avec prudence après une recherche approfondie!
Si vous pensez que le contenu utilisé sur ce site Web porte atteinte à vos droits d’auteur, veuillez nous contacter immédiatement (info@kdj.com) et nous le supprimerons dans les plus brefs délais.
-

- Midterms américains, marchés de prédiction et courses aux cryptomonnaies : un pari à enjeux élevés sur l'avenir de Washington
- Nov 04, 2026 at 04:05 am
- Les marchés de prédiction favorisent fortement les démocrates à mi-mandat aux États-Unis, avec une activité commerciale record et des implications importantes pour l'industrie de la cryptographie. Ces paris numériques prévoiront-ils avec précision le paysage politique et son impact sur la réglementation de la cryptographie ?
-
- Actifs numériques, finance mondiale et IA : franchir la prochaine frontière à DavosWeb3 et au-delà
- Nov 04, 2026 at 04:05 am
- DavosWeb3 réunit les dirigeants pour discuter de l'intégration des actifs numériques, de la finance mondiale et de l'IA. Ripple met en évidence l'essor de la tokenisation, tandis que XTEND AI Robotics présente une technologie avancée. Le futur est là !
-
- Le prix de l’Avalanche AVAX baisse au milieu de problèmes plus larges du marché ; L’intérêt institutionnel reste fort
- Nov 03, 2026 at 12:05 pm
- Le prix de l’Avalanche AVAX connaît un ralentissement, mais les données sur les produits dérivés et les développements institutionnels suggèrent une résilience sous-jacente. Explorez les facteurs clés qui influencent le prix d’AVAX.
-
- Pourquoi le prix quantitatif est-il en baisse ? Une plongée en profondeur dans la récente glissade de QNT au milieu de la nervosité du marché
- Nov 03, 2026 at 12:05 pm
- Le prix du Quant (QNT) chute dans un contexte de ralentissement plus large du marché de la cryptographie, entraîné par les chocs de change, les sorties de Bitcoin ETF et la peur croissante des investisseurs.
-
- Analyse du graphique des prix XRP d'Egrag Crypto : êtes-vous prêt pour la « plus grande vague 3 » ?
- Nov 03, 2026 at 12:05 am
- La dernière analyse d'Egrag Crypto suggère que le XRP est sur le point d'une hausse significative des prix, avec des objectifs pouvant atteindre 27 $ d'ici 2032, selon son Elliott Wave et les cadres techniques de support.
-
- La société mère de Bed Bath & Beyond soutient l'accord SPAC d'une valorisation de 350 millions de dollars de tZERO : ce que les New-Yorkais doivent savoir
- Nov 03, 2026 at 12:05 am
- La société mère de Bed Bath & Beyond, Neighborhood Intelligence (NXH), pousse son entreprise blockchain tZERO vers une cotation au NYSE américain via une fusion SPAC, valorisant tZERO à 350 millions de dollars. Cette décision constitue un tournant important pour l’entreprise, qui se concentre sur les actifs technologiques et numériques plutôt que sur la vente au détail traditionnelle.
-
- Arbitrum constate une augmentation du volume de transfert de Stablecoin, soutenu par un nouveau programme de croissance
- Nov 03, 2026 at 12:05 am
- Le jeton ARB d'Arbitrum connaît une augmentation significative du volume de transfert de pièces stables, grâce à de nouvelles initiatives visant à stimuler l'activité DeFi.
-
- Trump, la Corée du Nord et le braquage de Binance : un réseau de géopolitique et de criminalité numérique
- Nov 03, 2026 at 12:05 am
- Le piratage massif de Binance, lié à la Corée du Nord, a attiré l’attention de l’ancien président Trump et a relancé les débats sur la réglementation de la cryptographie, révélant l’intersection complexe de la sécurité numérique, des relations internationales et de la surveillance financière.
-
- Binance reprend les retraits pour XRP, DOGE, BTC et ETH lors de la réouverture progressive après un incident de sécurité
- Nov 03, 2026 at 12:05 am
- Binance rétablit progressivement les services de retrait pour les principales crypto-monnaies comme XRP, DOGE, BTC et ETH suite à une faille de sécurité importante. La réouverture progressive donne la priorité aux actifs très demandés.


