









 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
Articles d’actualité sur les crypto-monnaies
Explorer les états cachés des modèles de raisonnement de la chaîne de pensées pour réduire l'inefficacité de l'inférence
Apr 14, 2025 at 01:32 am
Les systèmes d'intelligence artificielle ont fait des progrès importants dans la simulation du raisonnement de style humain, en particulier les mathématiques et la logique. Ces modèles ne génèrent pas seulement des réponses - ils traversent une série d'étapes logiques pour tirer des conclusions, offrant des informations sur la façon et la raison pour laquelle ces réponses sont produites. Ce raisonnement étape par étape, souvent appelé chaîne de pensées (COT), est devenu essentiel dans la façon dont les machines gèrent des tâches complexes de résolution de problèmes.
Artificial intelligence systems have made remarkable progress in simulating human-style reasoning, especially in domains like mathematics and logic. Unlike typical generative models, these systems generate a series of intermediate steps to reach a final answer, offering insights into the reasoning process. This step-by-step reasoning, often called Chain-of-Thought (CoT), is crucial for machines to handle complex problem-solving tasks.
Les systèmes d'intelligence artificielle ont fait des progrès remarquables dans la simulation du raisonnement de style humain, en particulier dans des domaines comme les mathématiques et la logique. Contrairement aux modèles génératifs typiques, ces systèmes génèrent une série d'étapes intermédiaires pour atteindre une réponse finale, offrant un aperçu du processus de raisonnement. Ce raisonnement étape par étape, souvent appelé chaîne de réflexion (COT), est crucial pour que les machines génèrent des tâches complexes de résolution de problèmes.
A common challenge researchers face is the models' inefficiency during inference. The reasoning models may continue processing even after attaining a correct conclusion, leading to overthinking. This generates unnecessary tokens, increasing computational cost.
Un défi commun auxquels les chercheurs sont confrontés est l'inefficacité des modèles pendant l'inférence. Les modèles de raisonnement peuvent continuer à traiter même après avoir atteint une conclusion correcte, ce qui a entraîné une réflexion. Cela génère des jetons inutiles, augmentant le coût de calcul.
Many current approaches measure a model's confidence using verbal prompts or by analyzing multiple outputs. These "black-box" strategies ask the model to report how sure it is of its answer. However, they are often imprecise and computationally expensive. On the other hand, "white-box" methods investigate models' internal hidden states to extract signals that may correlate with answer correctness.
De nombreuses approches actuelles mesurent la confiance d'un modèle à l'aide d'invites verbales ou en analysant plusieurs sorties. Ces stratégies de "boîte noire" demandent au modèle de signaler à quel point il est sûr de sa réponse. Cependant, ils sont souvent imprécis et coûteux en calcul. D'un autre côté, les méthodes de "boîte blanche" étudient les états cachés internes des modèles pour extraire des signaux qui peuvent être en corrélation avec l'exactitude des réponses.
Prior work has shown that a model's internal states can indeed indicate the validity of final answers. However, applying this to intermediate steps in long reasoning chains is still an underexplored direction.
Des travaux antérieurs ont montré que les états internes d'un modèle peuvent en effet indiquer la validité des réponses finales. Cependant, l'application de cela aux étapes intermédiaires dans de longues chaînes de raisonnement est toujours une direction sous-explorée.
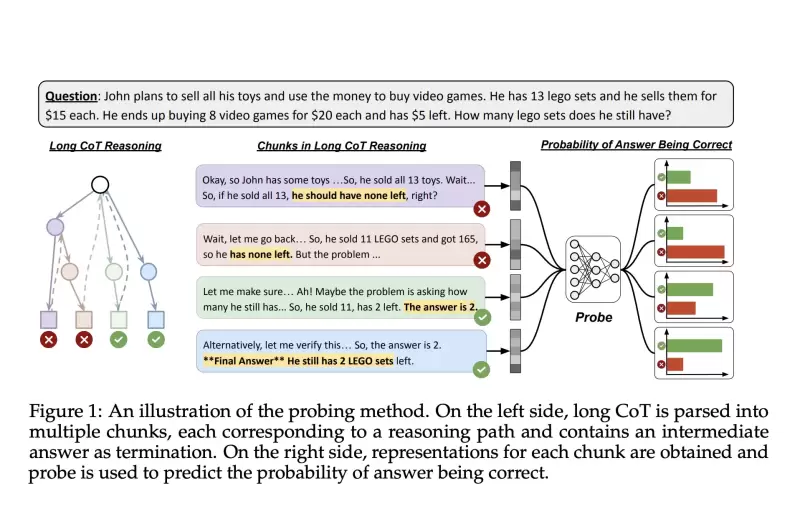
To bridge this gap, a team of researchers from New York University and NYU Shanghai designed a lightweight probe—a simple two-layer neural network—to inspect a model's hidden states at intermediate reasoning steps. Their models of choice were the DeepSeek-R1-Distill series and QwQ-32B, known for their excellent step-by-step reasoning capabilities, tested across various datasets including AIME, GSM8K, and MATH. The researchers trained their probe to read the internal state associated with each chunk of reasoning and predict whether the current intermediate answer was correct.
Pour combler cet écart, une équipe de chercheurs de l'Université de New York et de NYU Shanghai a conçu une sonde légère - un simple réseau neuronal à deux couches - pour inspecter les états cachés d'un modèle aux étapes de raisonnement intermédiaire. Leurs modèles de choix étaient la série Deepseek-R1-Distill et QWQ-32B, connue pour leurs excellentes capacités de raisonnement étape par étape, testées dans divers ensembles de données, notamment AIME, GSM8K et MATH. Les chercheurs ont formé leur sonde pour lire l'état interne associé à chaque morceau de raisonnement et prédire si la réponse intermédiaire actuelle était correcte.
To construct their approach, they segmented each long CoT output into smaller parts or chunks, using markers like "wait" or "verify" to identify breaks in reasoning. They used the last token's hidden state in each chunk as a representation and matched this to a correctness label, which was judged using another model. These representations were then used to train the probe on binary classification tasks. The probe was fine-tuned using grid search across hyperparameters like learning rate and hidden layer size, with most models converging to linear probes—highlighting that correctness information is often linearly embedded in the hidden states.
Pour construire leur approche, ils ont segmenté chaque longue sortie de lit en lit en pièces ou morceaux plus petits, en utilisant des marqueurs comme "attendre" ou "vérifier" pour identifier les ruptures de raisonnement. Ils ont utilisé l'état caché du dernier jeton dans chaque morceau en tant que représentation et correspondaient à cela à une étiquette d'exactitude, qui a été jugée à l'aide d'un autre modèle. Ces représentations ont ensuite été utilisées pour former la sonde sur les tâches de classification binaire. La sonde a été affinée en utilisant la recherche de grille à travers des hyperparamètres comme le taux d'apprentissage et la taille de la couche cachée, la plupart des modèles convergeant vers des sondes linéaires - l'élevage de la berline est souvent linéairement intégré dans les états cachés.
The probe worked effectively for fully formed answers and even showed the ability to predict correctness before an answer was completed, alluding to look-ahead capabilities.
La sonde a fonctionné efficacement pour des réponses entièrement formées et a même montré la capacité de prédire l'exactitude avant la fin d'une réponse, faisant allusion à des capacités à paraître.
Performance results were clear and quantifiable. The probes achieved ROC-AUC scores exceeding 0.9 for some datasets like AIME when using models like R1-Distill-Qwen-32B. Expected Calibration Errors (ECE) remained under 0.1, showcasing high reliability. For instance, R1-Distill-Qwen-32B had an ECE of just 0.01 on GSM8K and 0.06 on MATH.
Les résultats des performances étaient clairs et quantifiables. Les sondes ont obtenu des scores ROC-AUC dépassant 0,9 pour certains ensembles de données comme AIME lors de l'utilisation de modèles comme R1-Distill-QWEN-32B. Les erreurs d'étalonnage attendues (ECE) sont restées inférieures à 0,1, présentant une forte fiabilité. Par exemple, R1-Distill-QWEN-32B avait une ECE de seulement 0,01 sur GSM8K et 0,06 sur les mathématiques.
In application, the probe was used to implement a confidence-based early exit strategy during inference. The reasoning process was halted when the probe's confidence in an answer exceeded a threshold. At a confidence threshold of 0.85, the accuracy remained at 88.2%, while the inference token count was reduced by 24%. Even at a threshold of 0.9, accuracy stayed at 88.6%, with a 19% token reduction. Compared to static exit methods, this dynamic strategy achieved up to 5% higher accuracy using the same or fewer tokens.
Dans l'application, la sonde a été utilisée pour mettre en œuvre une stratégie de sortie précoce basée sur la confiance pendant l'inférence. Le processus de raisonnement a été interrompu lorsque la confiance de la sonde dans une réponse a dépassé un seuil. À un seuil de confiance de 0,85, la précision est restée à 88,2%, tandis que le nombre de jetons d'inférence a été réduit de 24%. Même à un seuil de 0,9, la précision est restée à 88,6%, avec une réduction de jeton de 19%. Par rapport aux méthodes de sortie statiques, cette stratégie dynamique a atteint une précision jusqu'à 5% plus élevée en utilisant les mêmes jetons ou moins.
This study provides an efficient, integrated way for reasoning models to self-verify during inference. The researchers' approach highlights a gap—models inherently know when they're right, but they don't act on it. This research opens up avenues for smarter, more efficient reasoning systems by leveraging internal representations through probing. It demonstrates that tapping into what the model already "knows" can lead to significant improvements in both performance and resource use.
Cette étude fournit un moyen efficace et intégré de raisonnement de motifs de s'auto-vérifier pendant l'inférence. L'approche des chercheurs met en évidence un écart - les modèles savent intrinsèquement quand ils ont raison, mais ils n'agissent pas dessus. Cette recherche ouvre des voies pour des systèmes de raisonnement plus intelligents et plus efficaces en tirant parti des représentations internes par sondage. Il démontre que le puisement de ce que le modèle "sait" peut entraîner des améliorations significatives à la fois des performances et de l'utilisation des ressources.
Clause de non-responsabilité:info@kdj.com
Les informations fournies ne constituent pas des conseils commerciaux. kdj.com n’assume aucune responsabilité pour les investissements effectués sur la base des informations fournies dans cet article. Les crypto-monnaies sont très volatiles et il est fortement recommandé d’investir avec prudence après une recherche approfondie!
Si vous pensez que le contenu utilisé sur ce site Web porte atteinte à vos droits d’auteur, veuillez nous contacter immédiatement (info@kdj.com) et nous le supprimerons dans les plus brefs délais.
-

- L'outil d'attaque DarkSword exploite les vulnérabilités iOS, posant une menace majeure pour la sécurité du portefeuille de crypto-monnaie
- Nov 05, 2026 at 04:05 am
- De nouvelles informations révèlent que l’outil d’attaque DarkSword exploite les failles de sécurité d’iOS pour cibler les portefeuilles de crypto-monnaie, mettant ainsi des millions de personnes en danger.
-
- Perte de crypto-monnaie dans une banque française : ZachXBT découvre un vol présumé de 133 millions de dollars au Crédit Mutuel Arkéa
- Nov 04, 2026 at 04:05 pm
- Le détective en chaîne ZachXBT a mis en lumière le géant bancaire français Crédit Mutuel Arkéa comme la victime présumée d'un vol de crypto dépassant 133 millions de dollars, soulevant des signaux d'alarme quant à la sécurité des actifs numériques de la finance traditionnelle.
-
- Les démocrates assurent le contrôle de la Chambre des représentants aux États-Unis, inaugurant une nouvelle ère pour le Congrès au milieu des élections de mi-mandat
- Nov 04, 2026 at 04:05 pm
- Les démocrates s’emparent du contrôle de la Chambre des représentants et du Congrès, ce qui marque un changement dans le pouvoir législatif et un contrôle accru de l’administration Trump.
-
- Midterms américains, marchés de prédiction et courses aux cryptomonnaies : un pari à enjeux élevés sur l'avenir de Washington
- Nov 04, 2026 at 04:05 am
- Les marchés de prédiction favorisent fortement les démocrates à mi-mandat aux États-Unis, avec une activité commerciale record et des implications importantes pour l'industrie de la cryptographie. Ces paris numériques prévoiront-ils avec précision le paysage politique et son impact sur la réglementation de la cryptographie ?
-
- Actifs numériques, finance mondiale et IA : franchir la prochaine frontière à DavosWeb3 et au-delà
- Nov 04, 2026 at 04:05 am
- DavosWeb3 réunit les dirigeants pour discuter de l'intégration des actifs numériques, de la finance mondiale et de l'IA. Ripple met en évidence l'essor de la tokenisation, tandis que XTEND AI Robotics présente une technologie avancée. Le futur est là !
-
- Le prix de l’Avalanche AVAX baisse au milieu de problèmes plus larges du marché ; L’intérêt institutionnel reste fort
- Nov 03, 2026 at 12:05 pm
- Le prix de l’Avalanche AVAX connaît un ralentissement, mais les données sur les produits dérivés et les développements institutionnels suggèrent une résilience sous-jacente. Explorez les facteurs clés qui influencent le prix d’AVAX.
-
- Pourquoi le prix quantitatif est-il en baisse ? Une plongée en profondeur dans la récente glissade de QNT au milieu de la nervosité du marché
- Nov 03, 2026 at 12:05 pm
- Le prix du Quant (QNT) chute dans un contexte de ralentissement plus large du marché de la cryptographie, entraîné par les chocs de change, les sorties de Bitcoin ETF et la peur croissante des investisseurs.
-
- Analyse du graphique des prix XRP d'Egrag Crypto : êtes-vous prêt pour la « plus grande vague 3 » ?
- Nov 03, 2026 at 12:05 am
- La dernière analyse d'Egrag Crypto suggère que le XRP est sur le point d'une hausse significative des prix, avec des objectifs pouvant atteindre 27 $ d'ici 2032, selon son Elliott Wave et les cadres techniques de support.
-
- La société mère de Bed Bath & Beyond soutient l'accord SPAC d'une valorisation de 350 millions de dollars de tZERO : ce que les New-Yorkais doivent savoir
- Nov 03, 2026 at 12:05 am
- La société mère de Bed Bath & Beyond, Neighborhood Intelligence (NXH), pousse son entreprise blockchain tZERO vers une cotation au NYSE américain via une fusion SPAC, valorisant tZERO à 350 millions de dollars. Cette décision constitue un tournant important pour l’entreprise, qui se concentre sur les actifs technologiques et numériques plutôt que sur la vente au détail traditionnelle.


