









 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
 |
|
Nachrichtenartikel zu Kryptowährungen
DeepSeek-V3: Ein 671B-Experten-Sprachmodell von DeepSeek-AI
Dec 27, 2024 at 12:32 pm
Der Bereich der Verarbeitung natürlicher Sprache (NLP) hat bei der Entwicklung groß angelegter Sprachmodelle (LLMs) erhebliche Fortschritte gemacht. Dieser Fortschritt bringt jedoch auch eigene Herausforderungen mit sich. Training und Inferenz erfordern erhebliche Rechenressourcen, die Verfügbarkeit verschiedener, qualitativ hochwertiger Datensätze ist entscheidend und die Erzielung einer ausgewogenen Nutzung in Mixture-of-Experts (MoE)-Architekturen bleibt komplex. Diese Faktoren tragen zu Ineffizienzen und erhöhten Kosten bei und stellen Hindernisse für die Skalierung von Open-Source-Modellen dar, um diese an proprietäre Modelle anzupassen. Darüber hinaus ist die Sicherstellung von Robustheit und Stabilität während des Trainings ein Dauerthema, da bereits geringfügige Instabilitäten die Leistung beeinträchtigen und kostspielige Eingriffe erforderlich machen können.
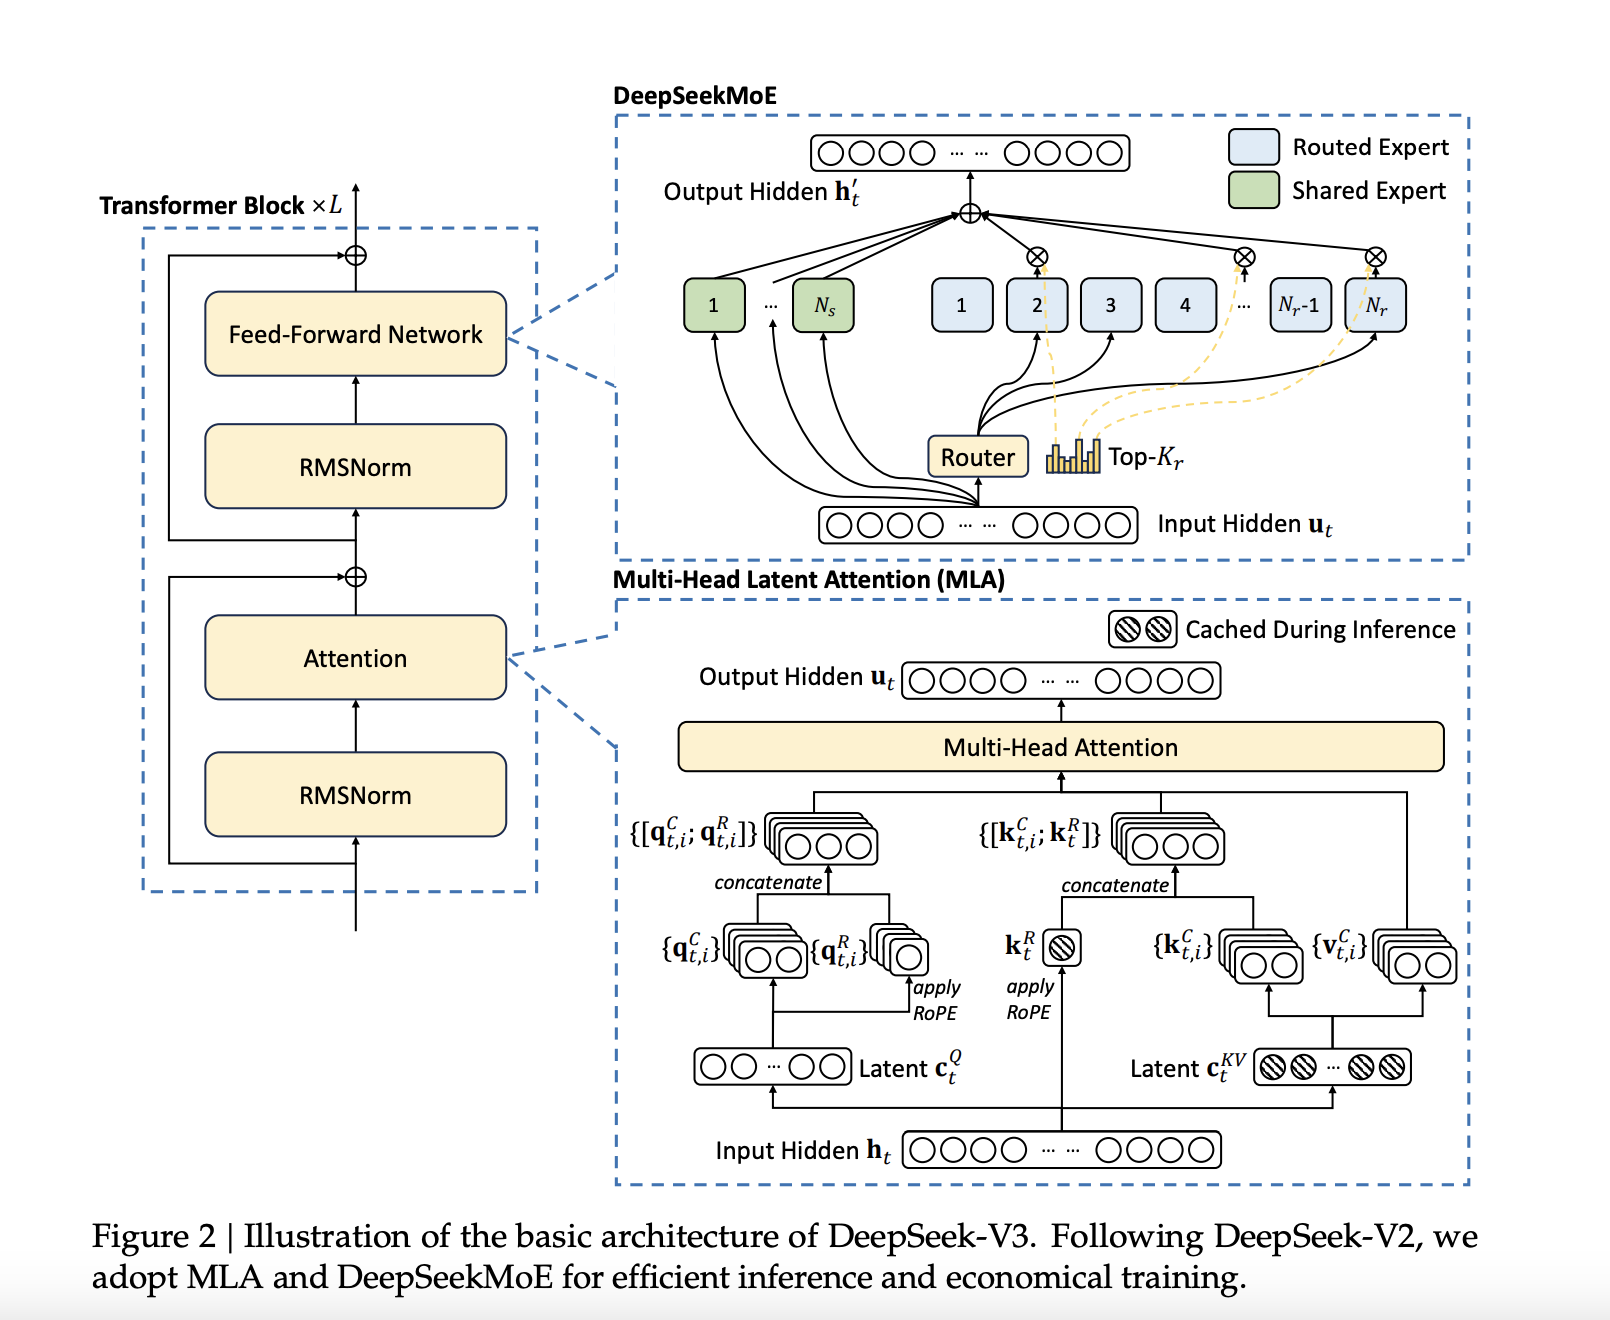
DeepSeek-AI has announced the release of DeepSeek-V3, a 671B Mixture-of-Experts (MoE) language model with 37B parameters activated per token. This latest model builds upon DeepSeek-AI's previous work on Multi-Head Latent Attention (MLA) and DeepSeekMoE architectures, which were refined in DeepSeek-V2 and DeepSeek-V2.5. DeepSeek-V3 is trained on a massive dataset of 14.8 trillion high-quality tokens, ensuring a broad and diverse knowledge base. Notably, DeepSeek-V3 is fully open-source, with accessible models, papers, and training frameworks for the research community to explore.
DeepSeek-AI hat die Veröffentlichung von DeepSeek-V3 angekündigt, einem 671B Mixture-of-Experts (MoE)-Sprachmodell mit 37B aktivierten Parametern pro Token. Dieses neueste Modell baut auf den früheren Arbeiten von DeepSeek-AI zu Multi-Head Latent Attention (MLA) und DeepSeekMoE-Architekturen auf, die in DeepSeek-V2 und DeepSeek-V2.5 verfeinert wurden. DeepSeek-V3 basiert auf einem riesigen Datensatz von 14,8 Billionen hochwertigen Tokens und gewährleistet so eine breite und vielfältige Wissensbasis. Bemerkenswert ist, dass DeepSeek-V3 vollständig Open Source ist und der Forschungsgemeinschaft zugängliche Modelle, Dokumente und Schulungsrahmen bietet, die sie erkunden kann.
Technical Details and BenefitsSeveral innovations are incorporated into DeepSeek-V3 to address long-standing challenges in the field. An auxiliary-loss-free load balancing strategy efficiently distributes computational loads across experts while maintaining model performance. Moreover, a multi-token prediction training objective enhances data efficiency and enables faster inference through speculative decoding.
Technische Details und Vorteile: Mehrere Innovationen sind in DeepSeek-V3 integriert, um seit langem bestehende Herausforderungen in diesem Bereich zu bewältigen. Eine hilfsverlustfreie Lastausgleichsstrategie verteilt die Rechenlasten effizient auf Experten und behält gleichzeitig die Modellleistung bei. Darüber hinaus verbessert ein Multi-Token-Vorhersagetrainingsziel die Dateneffizienz und ermöglicht schnellere Schlussfolgerungen durch spekulative Dekodierung.
Additionally, FP8 mixed precision training improves computational efficiency by reducing GPU memory usage without sacrificing accuracy. The DualPipe algorithm further minimizes pipeline bubbles by overlapping computation and communication phases, reducing all-to-all communication overhead. These advancements allow DeepSeek-V3 to process 60 tokens per second during inference—a significant improvement over DeepSeek-V2.5.
Darüber hinaus verbessert das FP8-Training mit gemischter Präzision die Recheneffizienz, indem es die GPU-Speichernutzung reduziert, ohne die Genauigkeit zu beeinträchtigen. Der DualPipe-Algorithmus minimiert Pipeline-Blasen weiter, indem er Berechnungs- und Kommunikationsphasen überlappt, wodurch der Gesamtkommunikationsaufwand reduziert wird. Diese Fortschritte ermöglichen es DeepSeek-V3, 60 Token pro Sekunde während der Inferenz zu verarbeiten – eine deutliche Verbesserung gegenüber DeepSeek-V2.5.
Performance Insights and ResultsDeepSeek-V3 is evaluated across multiple benchmarks, showcasing strong performance. On educational datasets like MMLU and MMLU-Pro, DeepSeek-V3 achieves scores of 88.5 and 75.9, respectively, outperforming other open-source models. In mathematical reasoning tasks, DeepSeek-V3 sets new standards with a score of 90.2 on MATH-500. The model also performs exceptionally in coding benchmarks such as LiveCodeBench.
Leistungseinblicke und -ergebnisseDeepSeek-V3 wird in mehreren Benchmarks bewertet und zeigt eine starke Leistung. Bei Bildungsdatensätzen wie MMLU und MMLU-Pro erreicht DeepSeek-V3 Werte von 88,5 bzw. 75,9 und übertrifft damit andere Open-Source-Modelle. Bei mathematischen Denkaufgaben setzt DeepSeek-V3 mit einer Punktzahl von 90,2 bei MATH-500 neue Maßstäbe. Auch bei Codierungs-Benchmarks wie LiveCodeBench schneidet das Modell hervorragend ab.
Despite these achievements, the training cost is kept relatively low at $5.576 million, requiring only 2.788 million H800 GPU hours. These results highlight DeepSeek-V3’s efficiency and its potential to make high-performance LLMs more accessible.
Trotz dieser Erfolge bleiben die Schulungskosten mit 5,576 Millionen US-Dollar relativ niedrig und erfordern nur 2,788 Millionen H800-GPU-Stunden. Diese Ergebnisse unterstreichen die Effizienz von DeepSeek-V3 und sein Potenzial, Hochleistungs-LLMs zugänglicher zu machen.
ConclusionDeepSeek-V3 marks a significant advancement in open-source NLP research. By tackling the computational and architectural challenges associated with large-scale language models, DeepSeek-AI establishes a new benchmark for efficiency and performance. DeepSeek-V3 sets a new standard for open-source LLMs, achieving a balance of performance and efficiency that makes it a competitive alternative to proprietary models. DeepSeek-AI's commitment to open-source development ensures that the broader research community can benefit from its advancements.
Fazit: DeepSeek-V3 stellt einen bedeutenden Fortschritt in der Open-Source-NLP-Forschung dar. Durch die Bewältigung der rechnerischen und architektonischen Herausforderungen, die mit großen Sprachmodellen verbunden sind, setzt DeepSeek-AI einen neuen Maßstab für Effizienz und Leistung. DeepSeek-V3 setzt einen neuen Standard für Open-Source-LLMs und erreicht ein Gleichgewicht aus Leistung und Effizienz, das es zu einer wettbewerbsfähigen Alternative zu proprietären Modellen macht. Das Engagement von DeepSeek-AI für die Open-Source-Entwicklung stellt sicher, dass die breitere Forschungsgemeinschaft von seinen Fortschritten profitieren kann.
Check out the Paper, GitHub Page, and Model on Hugging Face. All credit for this research goes to the researchers of this project. Also, don’t forget to follow us on Twitter and join our Telegram Channel and LinkedIn Group. Don’t Forget to join our 60k+ ML SubReddit.
Schauen Sie sich den Artikel, die GitHub-Seite und das Modell zu Hugging Face an. Alle Anerkennung für diese Forschung gebührt den Forschern dieses Projekts. Vergessen Sie auch nicht, uns auf Twitter zu folgen und unserem Telegram-Kanal und unserer LinkedIn-Gruppe beizutreten. Vergessen Sie nicht, unserem über 60.000 ML großen SubReddit beizutreten.
Trending: LG AI Research Releases EXAONE 3.5: Three Open-Source Bilingual Frontier AI-level Models
Im Trend: LG AI Research veröffentlicht EXAONE 3.5: Drei Open-Source-Modelle auf KI-Ebene für zweisprachige Frontier
Haftungsausschluss:info@kdj.com
Die bereitgestellten Informationen stellen keine Handelsberatung dar. kdj.com übernimmt keine Verantwortung für Investitionen, die auf der Grundlage der in diesem Artikel bereitgestellten Informationen getätigt werden. Kryptowährungen sind sehr volatil und es wird dringend empfohlen, nach gründlicher Recherche mit Vorsicht zu investieren!
Wenn Sie glauben, dass der auf dieser Website verwendete Inhalt Ihr Urheberrecht verletzt, kontaktieren Sie uns bitte umgehend (info@kdj.com) und wir werden ihn umgehend löschen.
-

- Near.com und Ondo Finance eröffnen neue Möglichkeiten für tokenisierte Aktien, ETFs und Rohstoffe
- Sep 23, 2026 at 04:05 am
- Near.com und Ondo Finance mischen die Investmentwelt auf, indem sie berechtigten Benutzern nahtlosen Zugriff auf tokenisierte Aktien, ETFs und Rohstoffe über ein einziges Konto gewähren und so die Integration traditioneller und digitaler Vermögenswerte rationalisieren.
-
- NEAR-Protokolllösungen bekämpfen verlorene Schlüssel und verbessern die Benutzerfreundlichkeit mit lesbaren Konten
- Sep 23, 2026 at 04:05 am
- Die neuen Funktionen des NEAR-Protokolls, darunter lesbare Kontonamen und eine robuste Schlüsselwiederherstellung, werden die Benutzererfahrung und Sicherheit der Blockchain revolutionieren und das Problem des anhaltenden Verlusts von Schlüsseln angehen.
-
- Zcash steht im Mittelpunkt: Europäische ETP-Einführung folgt auf US-ETF-Genehmigung und entfacht Debatte über „Bitcoin-Alternative“.
- Sep 23, 2026 at 04:05 am
- Zcash gewinnt mit neuen europäischen ETPs von 21Shares und einer vorherigen US-ETF-Zulassung an institutioneller Bedeutung, was trotz höherer Gebühren und behördlicher Kontrolle von Privacy Coins erneute Diskussionen über sein Potenzial als Bitcoin-Alternative auslöst.
-
- 21Shares erweitert Produktsuite mit neuem Zcash ETP und verbessert so den Zugang für europäische Anleger
- Sep 23, 2026 at 04:05 am
- 21Shares erweitert sein europäisches Krypto-ETP-Angebot durch die Einführung eines Zcash-ETP und markiert damit einen bedeutenden Schritt bei der Erweiterung regulierter Anlagemöglichkeiten für digitale Vermögenswerte.
-
- Aave-Kreditlimit, Bitcoin-gestützte Kredite: Strikes „volatilitätssichere“ Lösung inmitten der Verschärfung der Aave-Vorschläge
- Sep 23, 2026 at 04:05 am
- Strike führt ein „volatilitätssicheres“ Bitcoin-gestütztes Kreditprodukt ein, das Schutz vor marktbedingten Liquidationen bietet, da Aave erwägt, die Kreditlimits für BTC-gedeckte Positionen zu verschärfen, was möglicherweise die Liquidationsrisiken erhöht.
-
- CME Group erweitert Krypto-Angebote mit Bitcoin Cash und Uniswap-Futures angesichts des wachsenden institutionellen Interesses
- Sep 23, 2026 at 04:05 am
- Die CME Group führt Bitcoin Cash- und Uniswap-Futures ein und signalisiert damit einen bedeutenden Schritt bei der institutionellen Krypto-Einführung und dem Risikomanagement.
-
- White-Hat-Hacker sichern sich Bitcoin bei der Wiederherstellung von Coldcard-Exploits und entfachen damit eine Debatte über die Verwahrung von Geldern
- Sep 23, 2026 at 04:05 am
- White-Hat-Hacker greifen in einen Coldcard-Bitcoin-Exploit ein, transferieren Gelder an Recovery Trust und werfen Fragen zur Vermögensrückgewinnung und -verwahrung im Kryptoraum auf.
-
- Strives aufstrebendes Bitcoin-Finanzministerium: Ein New Yorker Geisteszustand für Unternehmenskrypto
- Sep 22, 2026 at 08:05 am
- Strive setzt seine starke Anhäufung von Bitcoin fort und präsentiert eine klare Strategie für das Treasury-Management von Unternehmen im digitalen Zeitalter. Dieser Schritt unterstreicht den wachsenden Trend bei Unternehmen, Krypto als Kernwert zu nutzen.
-
- Apple und Google nutzen Stablecoin-Experten und signalisieren damit einen großen Wandel in der Krypto-Zahlungsstrategie
- Sep 22, 2026 at 04:05 am
- Die Technologiegiganten Apple und Google stellen aktiv Stablecoin- und Blockchain-Spezialisten ein und signalisieren damit eine bedeutende Weiterentwicklung ihres Ansatzes für Kryptozahlungen und Finanzinfrastruktur.


